

Peak Test Daten Manager trifft auf Databricks: Aufbau einer KI-fähigen Engineering-Datenplattform
KUNDEN ERFOLGSGESCHICHTE
Wie ein weltweit agierender Automobilhersteller verlässliche Engineering-Daten mit Analytik und KI im Unternehmensmaßstab verknüpft.
[In der Blog-Übersicht wird hier ein Weiterlesen-Link angezeigt]
Die Herausforderung: Ingenieurtechnische Daten in Unternehmenswert umwandeln
Erfolgreiche technische Organisationen investieren in Unternehmensdatenplattformen und künstliche Intelligenz, um aus immer umfangreicheren und vielfältigeren Datensätzen Erkenntnisse zu gewinnen. Technologien wie Databricks bilden die Grundlage für die großskalige Datenverarbeitung, maschinelles Lernen und KI. Doch eine skalierbare Infrastruktur für Datenverarbeitung und Analysen allein reicht nicht aus, um Messdaten verständlich, nachvollziehbar oder für eine zuverlässige Analyse nutzbar zu machen.
Prüfstände, Simulationen und Tests unter realen Bedingungen erzeugen Daten in heterogenen Formaten, mit unterschiedlichen Strukturen und fachspezifischen Bedeutungen. Um eine Messung korrekt interpretieren zu können, benötigen Ingenieure mehr als nur das Rohsignal: Sie brauchen Informationen über das Prüfobjekt, die Konfiguration, den Versuchsablauf, die Rahmenbedingungen sowie die Herkunft der Daten. Ohne diesen Kontext kann die Zusammenführung von Datensätzen über verschiedene Standorte und Fachdisziplinen hinweg zu einem kostspieligen, manuellen Aufwand werden.
Die Zielsetzung des Kunden
Ein bedeutender internationaler Automobilhersteller verfolgte das Ziel, eine zentralisierte, weltweit zugängliche und vertrauenswürdige Umgebung für die Verwaltung und Analyse von Test- und Messdaten zu schaffen – und zwar sowohl für physische als auch für virtuelle Testbereiche. Die Plattform sollte global verteilte Entwicklungsteams sowie unterschiedliche technische Fachdisziplinen unterstützen, ohne dabei einen starren Arbeitsablauf vorzugeben oder die von den Teams bevorzugten Entwicklungswerkzeuge zu ersetzen.
Die strategische Entscheidung bestand darin, eine etablierte Plattform für das Management von Entwicklungsdaten mit einer skalierbaren Enterprise-Analytics-Plattform zu kombinieren. „Peak Test Data Manager“ (PeakTDM) – basierend auf dem ASAM ODS-Standard – bietet die erforderlichen fachspezifischen Funktionen und einen standardisierten Zugriff auf Testdaten, während Databricks eine skalierbare Datenverarbeitung sowie fortschrittliche Analysefunktionen bereitstellt.
Eine auf Wiederverwendbarkeit ausgelegte Architektur
Anstatt für jeden neuen analytischen Anwendungsfall die Datenaufnahme, das Metadatenmanagement und die Werkzeugschnittstellen jeweils neu zu entwickeln, setzt das Projekt auf drei einander ergänzende Schichten: eine Datenschicht, eine dedizierte Integrationsschicht sowie Databricks als zentrale Analyse- und KI-Umgebung. Diese Aufgabenteilung ermöglicht es, im Laufe der Zeit neue Testbereiche und Anwendungen zu integrieren, ohne dass grundlegende Funktionalitäten jedes Mal von Grund auf neu implementiert werden müssen.
Die Lösung: Drei einander ergänzende architektonische Schichten
Schicht 1 — Engineering-Datenbasis: Peak Test Daten Manager
PeakTDM schafft eine verteilte, mandantenfähige Basis, die auf dem ASAM-ODS-Standard und dem darauf aufbauenden openMDM-Anwendungsmodell basiert. Auf diese Weise können einzelne Testdomänen ihre eigenen Metadatenmodelle und domänenspezifischen Funktionalitäten nutzen, während sie gleichzeitig von einheitlichen Prinzipien des Datenmanagements profitieren. Die Architektur ist so konzipiert, dass sie unterschiedliche Ingenieurdisziplinen unterstützt, anstatt ein einziges, universelles Datenmodell vorzugeben.
Konfigurierbare und überwachbare Datenaufnahme-Pipelines (Ingestion Pipelines) integrieren heterogene Testdaten aus verschiedenen Testumgebungen, validieren und harmonisieren die eingehenden Informationen und bewahren dabei deren technischen Kontext. Über eine Weboberfläche können Ingenieure importierte Datensätze durchsuchen, navigieren und untersuchen – unabhängig von den verwendeten Werkzeugen, Teams oder Standorten. Dank standardisierter Schnittstellen können zudem bewährte Werkzeuge für Analysen und nachgelagerte Verarbeitungsschritte weiterhin genutzt werden.
Die domänenspezifischen Datenmanagement-Anwendungen sind containerisiert und werden in privaten Cloud-Umgebungen bereitgestellt. Dies ermöglicht einen einheitlichen Ansatz für geografisch verteilte Standorte, wobei die Flexibilität, die für die jeweiligen Testdomänen erforderlich ist, vollständig erhalten bleibt.
Schicht 2 — Integration: Technische Daten treffen auf skalierbare Analytik
Der Peak ODS-Adapter für Apache Spark verbindet die Datenschicht mit Spark-basierten Analysen und ermöglicht den Zugriff auf Metadaten sowie Messdaten mittels Spark SQL und Pandas DataFrames. Je nach Anwendungsfall können die Informationen direkt abgerufen oder über konfigurierbare Transformations-Pipelines bereitgestellt werden.
Diese Flexibilität ist bei umfangreichen Messdatensätzen von großer Bedeutung: Die ursprünglichen Massendaten verbleiben in der Datenmanagement-Infrastruktur, während ausgewählte Teilmengen, abgeleitete Merkmale oder analytische Kennzahlen für die weitere Verarbeitung zur Verfügung gestellt werden. Die Integrationsschicht kann zudem KI-Anwendungen über den „Peak AI Connect MCP Service“ unterstützen; dies ermöglicht es intelligenten Agenten, bei Bedarf relevante Datensätze zu identifizieren und auf deren bestehenden Kontext zuzugreifen.
Schicht 3 — Unternehmensanalytik und KI: Databricks
Databricks stellt die Infrastruktur für skalierbare Datenverarbeitung und Analytik bereit. Der „Lakehouse“-Ansatz kombiniert dabei die Flexibilität eines Data Lakes mit der strukturierten Datenorganisation und den Abfragemöglichkeiten eines Data Warehouse. Komponenten wie Apache Spark, Delta Lake, Unity Catalog und MLflow unterstützen Data Engineering, Governance, maschinelles Lernen sowie KI-gestützte Arbeitsabläufe.
Zu den potenziellen Anwendungsfällen zählen unter anderem test- und domänenübergreifende Analysen, die automatisierte Merkmalsextraktion aus Zeitreihen, Anomalieerkennung, prädiktive Entwicklung (Predictive Engineering), automatisiertes Berichtswesen sowie intelligente Assistenzsysteme für den Entwicklungs- und Konstruktionsprozess.
Obwohl die genannten Anwendungsbeispiele im aktuellen Projekt noch nicht umgesetzt wurden, stellen sie Möglichkeiten dar, die durch die Architektur unterstützt werden und sich problemlos implementieren lassen.
Referenzarchitektur im Überblick
Die folgende Grafik veranschaulicht die Architektur der entwickelten Lösung, die als Referenz für zukünftige Implementierungen dient.
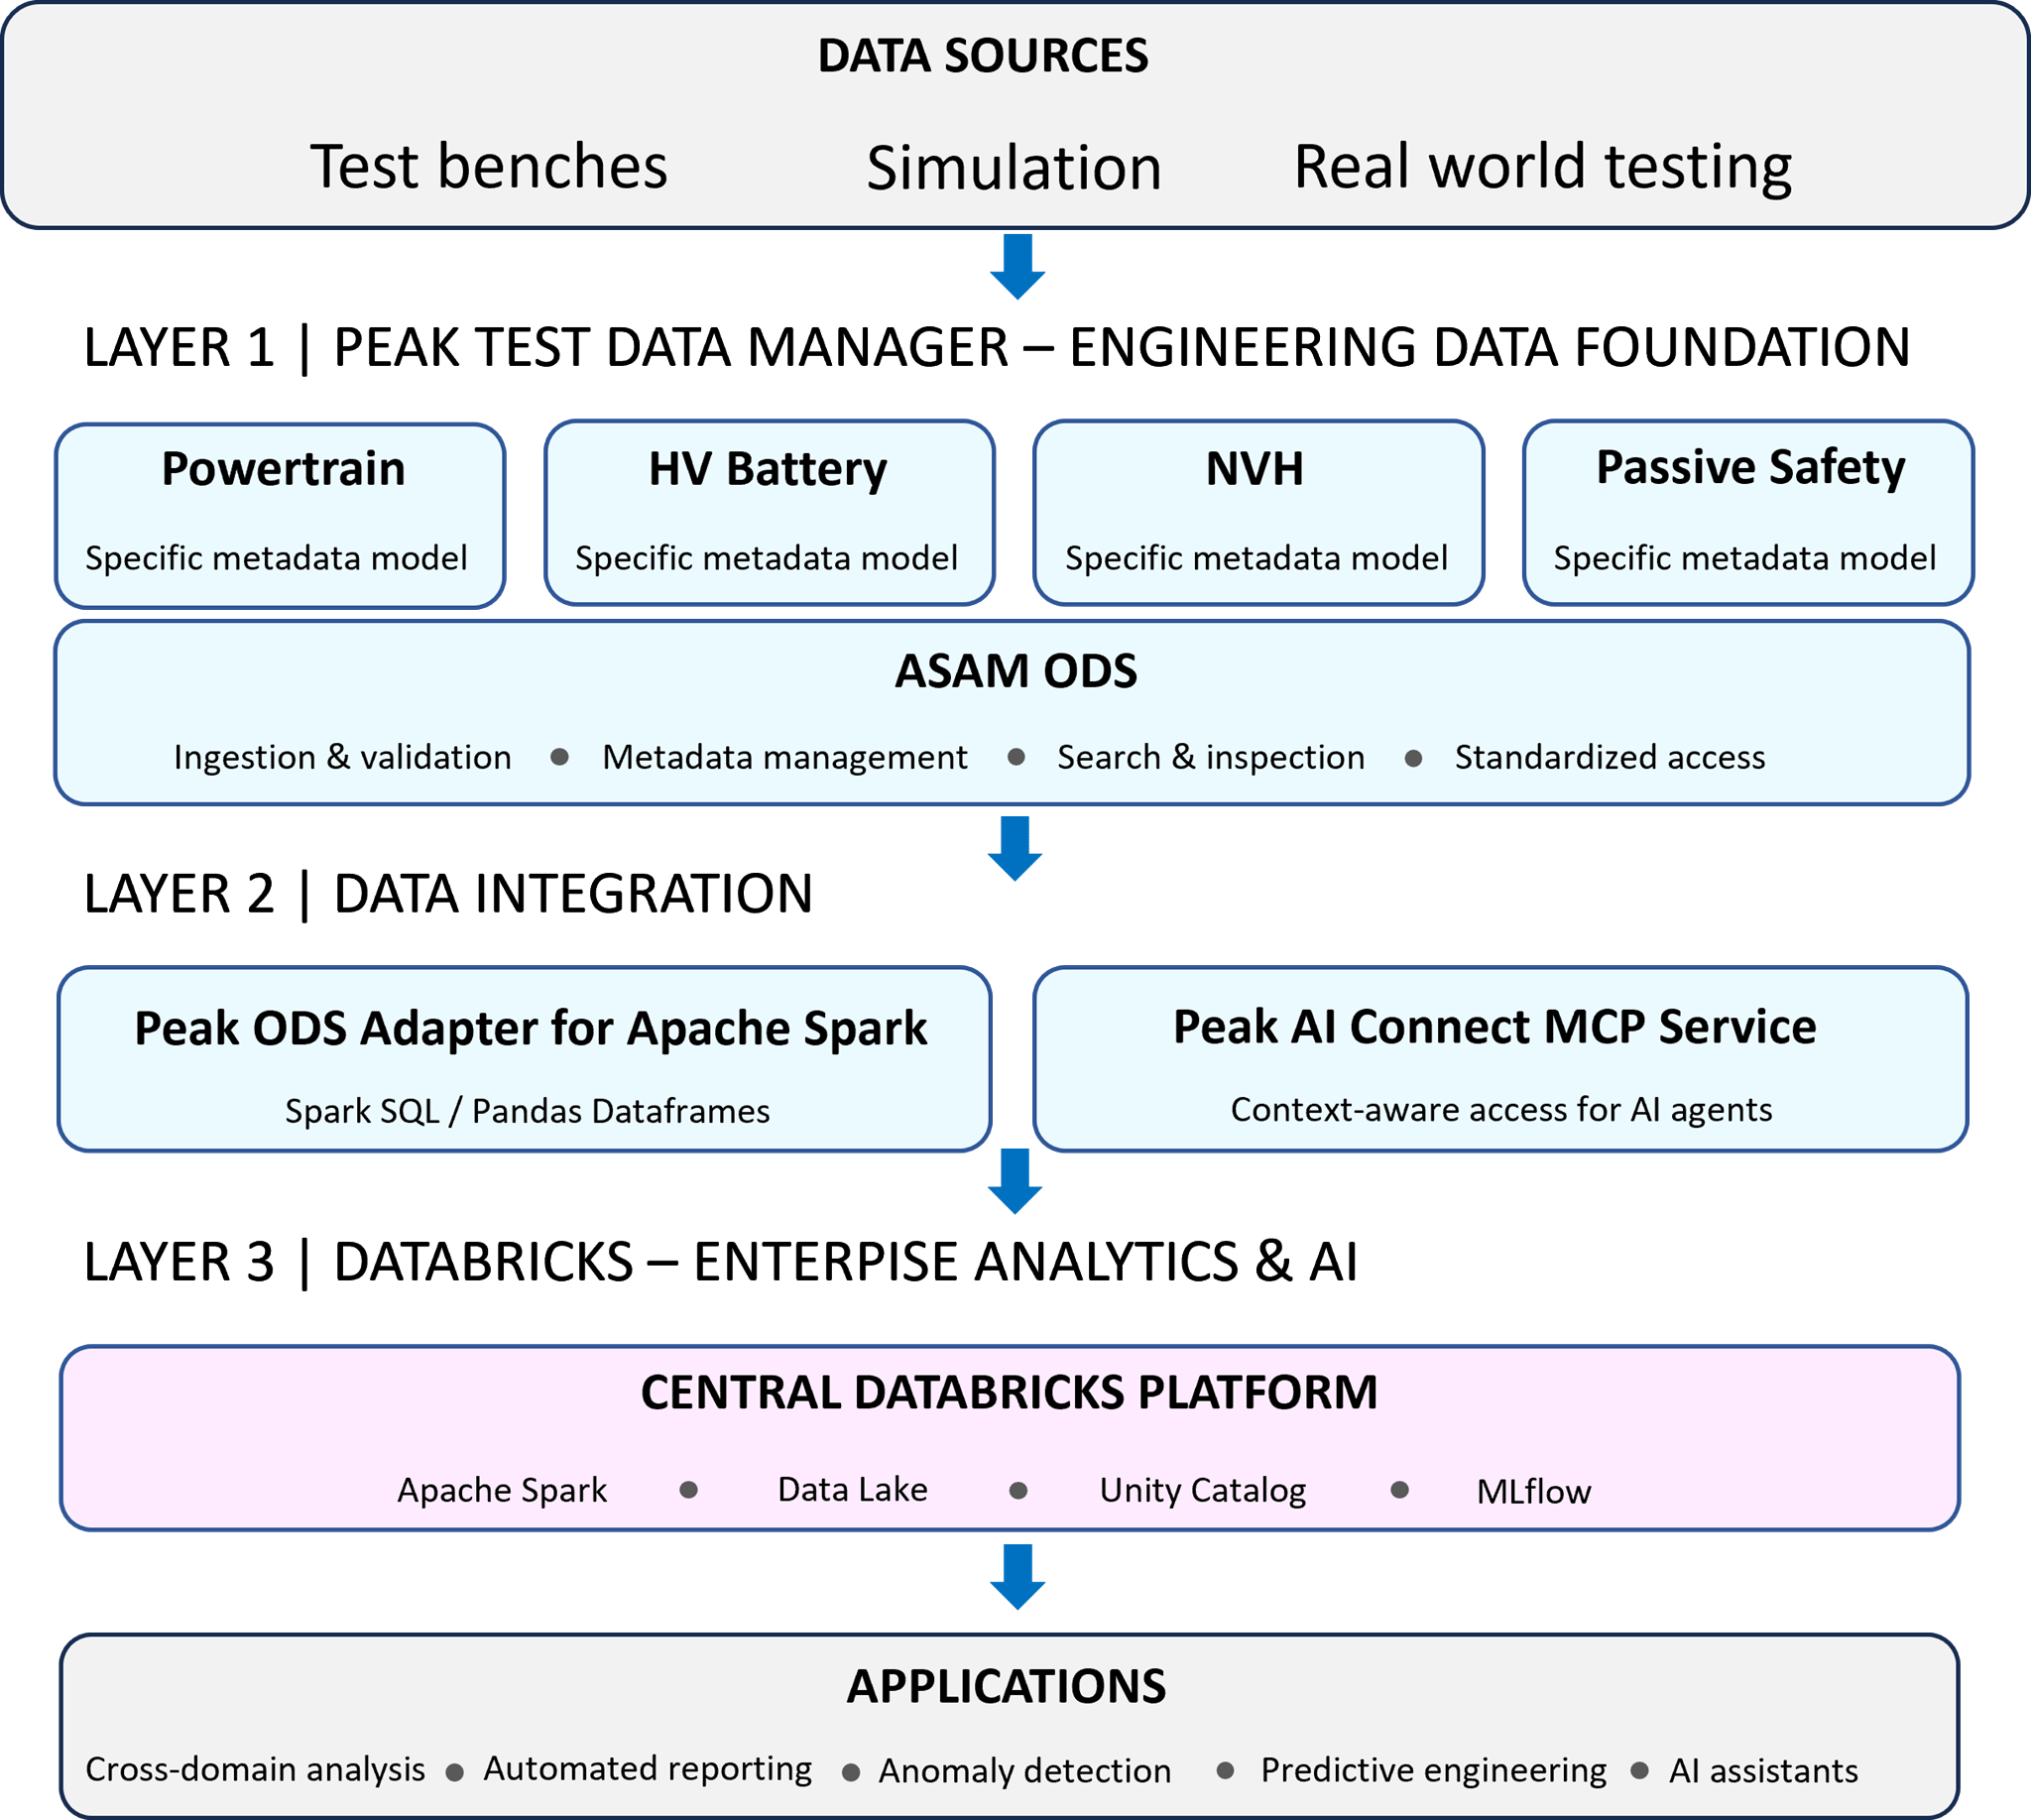
Konzeptionelle Referenzarchitektur. Die dargestellten Domänen und analytischen Anwendungsfälle veranschaulichen das wiederverwendbare Design;
die konkrete Implementierung sowie die Verbindungen hängen von der jeweiligen Projektkonfiguration ab.
Geschäftliche Auswirkungen: Eine solidere Grundlage für technische Erkenntnisse
Eine Grundlage, viele Testdomänen
Die Plattform vereint verschiedene Testdomänen in einer gemeinsamen Datenverwaltungsstrategie, ohne ihre technische Spezifität zu verlieren. Domänenspezifische Metadatenmodelle bewahren die Bedeutung einzelner Messungen, während gemeinsame Zugriffsmechanismen das Auffinden, Interpretieren und Wiederverwenden von Ergebnissen über Organisationsgrenzen hinweg erleichtern.
Geringerer Integrationsaufwand und höhere Flexibilität
Wiederverwendbare Funktionen für Datenaufnahme, Validierung, Metadatenverwaltung und Zugriff verringern die Notwendigkeit, grundlegende Datenmanagement-Funktionen in jedem Analyseprojekt immer wieder neu zu implementieren. Teams können ihre analytischen Workloads unabhängig von den zugrunde liegenden Testsystemen weiterentwickeln und neue Datenquellen über etablierte Mechanismen anbinden.
Skalierbare Analyse ohne wahllose Datenduplizierung
Der direkte Zugriff auf Basis von Spark ermöglicht in Kombination mit konfigurierbaren Datentransformationen, die Datenbereitstellung passgenau auf spezifische Analyseanforderungen zuzuschneiden. Es ist nicht immer erforderlich, vollständige Rohdatensätze in die Analyseumgebung zu kopieren: Gezielte Teilmengen sowie abgeleitete Informationen lassen sich genau dort verarbeiten, wo sie benötigt werden und einen Mehrwert bieten.
Ein praxisorientierter Weg zur KI-gestützten Entwicklung
KI-Anwendungen sind auf den Zugriff auf vertrauenswürdige und gut beschriebene Informationen angewiesen. Indem der technische Kontext in der Datengrundlage bewahrt und über standardisierte Schnittstellen zugänglich gemacht wird, verringert die Architektur die Notwendigkeit, die Bedeutung von Testdaten für jeden neuen KI-Workflow jeweils eigenständig neu erschließen zu müssen.
Warum Peak Solution
Peak Solution verbindet langjährige Erfahrung im Bereich des auf ASAM ODS basierenden Testdatenmanagements mit ausgereiften, wiederverwendbaren Softwarekomponenten sowie fundierter Integrationskompetenz. Dieser Ansatz schützt Investitionen in bestehende Test- und Analysewerkzeuge, unterstützt offene Standards und schafft eine Basis, die mit neuen Testdomänen und analytischen Anforderungen mitwachsen kann.
Das Fazit
Das Beispiel aus der globalen Automobilindustrie zeigt, dass eine moderne Plattform für technische Daten und KI nicht von Grund auf neu entwickelt werden muss. PeakTDM beherrscht die Komplexität technischer Daten direkt an der Quelle, während Databricks die Analytik dort skaliert, wo sie einen Mehrwert schafft. Gemeinsam verknüpfen sie operative Testumgebungen mit unternehmensweiter Innovation.
Setzen Sie auf eine KI-Lösung, die auf einem bereits bewährten Fundament technischer Daten aufbaut.
Verbundene Lösungen
Die richtigen Komponenten. Die richtige Lösung. Für Ihre technischen Herausforderungen.
Peak Test Data Manager
Hören Sie auf, nach Testdaten zu suchen. Fangen Sie an, diese in einen echten Mehrwert für Ihre technische Arbeit zu verwandeln. Wandeln Sie verstreute Messdaten in eine verlässliche, jederzeit zugängliche und KI-fähige Datenbasis um.
Peak ODS Server
Messdaten speichern und abrufen – mithilfe offener ASAM-ODS-Modelle und standardisierter APIs.
Peak ODS-Adapter für Apache Spark
Verbinden Sie Ihre Testdaten mit skalierbaren Big-Data-Umgebungen und Analyseplattformen.
Peak KI Verbindung
Verbinden Sie gesteuerte Testdaten mit KI-gestützten Analyse-Workflows über den Peak AI Connect MCP Server, wobei die Ingenieure die Kontrolle über die Ergebnisse behalten.
