

Die versteckten Kosten eines mangelhaften Testdatenmanagements im Ingenieurwesen
Wiederholte Tests, verlorene Entwicklungszeit, inkonsistente Entscheidungen sowie KI-Projekte, die auf unzuverlässigen Daten basieren – die tatsächlichen Kosten fragmentierter Messdaten gehen weit über den reinen Speicheraufwand hinaus.
[In der Blog-Übersicht wird hier ein Weiterlesen-Link angezeigt]
Test- und Messdaten haben sich zu einem strategischen Wert im Ingenieurwesen entwickelt. Täglich entstehen in Entwicklungslaboren, auf Prüfständen, auf Testgeländen sowie in Simulationsumgebungen riesige Datenmengen. Oft sind diese Daten jedoch über Dateisysteme, proprietäre Werkzeuge, lokale Datenbanken und abteilungsspezifische Lösungen hinweg fragmentiert.
Das Ergebnis ist nicht bloß eine unpraktische Datenspeicherung. Die Fragmentierung kann zu wiederholten Testkampagnen, Verzögerungen bei technischen Entscheidungen, uneinheitlichen Ergebnissen, eingeschränkter Rückverfolgbarkeit sowie verpassten Innovationschancen führen.
Was sind Testdatensilos?
Testdatensilos entstehen, wenn Mess- und Validierungsergebnisse isoliert in Dateiservern, proprietären Tool-Umgebungen, abteilungsspezifischen Datenbanken, lokalen Tabellenkalkulationen oder Skripten verbleiben – häufig mit inkonsistenten Metadaten.
Innerhalb eines einzelnen Teams mögen solche Ansätze gut funktionieren. In einer gesamten Entwicklungsorganisation erschweren sie jedoch Folgendes:
- Frühere Testergebnisse finden und wiederverwenden.
- Messungen über Projekte und Testkampagnen hinweg vergleichen.
- Den für eine langfristige Interpretation erforderlichen technischen Kontext bewahren.
- Den Zugriff auf sensible Entwicklungsinformationen steuern.
- Vertrauenswürdige Daten für Analysen und KI bereitstellen.
Vier versteckte Kosten durch fragmentierte Testdaten
Die meisten Unternehmen erkennen die direkten Kosten von Tests. Die indirekten Kosten eines mangelhaften Datenmanagements sind weniger offensichtlich – können sich jedoch über verschiedene Entwicklungsabteilungen hinweg summieren.
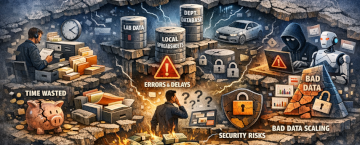
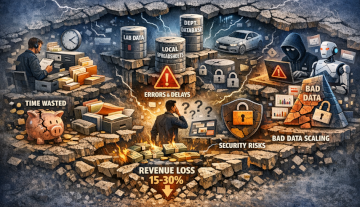
- Zeitverlust im Engineering durch Datenaufbereitung: Ingenieure verbringen wertvolle Zeit mit dem Suchen, Bereinigen, Konvertieren und Abgleichen von Messdaten, anstatt Ergebnisse zu analysieren und technische Probleme zu lösen.
- Fehler und wiederholte Validierung: Fehlende oder widersprüchliche Metadaten führen zu Unsicherheiten, fehlerhaften Vergleichen, wiederholten Validierungsschleifen und Verzögerungen bei technischen Freigabeentscheidungen.
- Risiken für Sicherheit und Compliance: Ohne zentralen Überblick fällt es Unternehmen schwer nachzuvollziehen, wer Zugriff auf welche Daten hat, wie Änderungen kontrolliert werden und ob Nachweise revisionssicher bleiben.
- Skalierung mangelhafter Datenqualität durch KI: KI-Agenten und Analyse-Workflows können unzuverlässige Metadaten nicht ausgleichen. Ohne eine verlässliche Datenbasis besteht die Gefahr, dass sich Fehler in Dashboards, Berichte und Entscheidungsprozesse übertragen.
Selbst wenn einzelne Ineffizienzen gering erscheinen, können sie sich über zahlreiche Teams und Testkampagnen hinweg summieren. In Testumgebungen ist die Notwendigkeit, einen aufwendigen physischen Test zu wiederholen – etwa weil frühere Daten nicht mehr auffindbar oder interpretierbar sind –, ein besonders kostspieliges Beispiel hierfür.
Die bekannte 1-10-100-Regel besagt, dass die Kosten für die Behebung eines Problems in jeder nachfolgenden Phase etwa um den Faktor zehn steigen: Vorbeugung ist am günstigsten, eine nachträgliche Korrektur ist teurer, und das Ignorieren des Problems kommt besonders teuer zu stehen. In Testumgebungen bedeutet dies beispielsweise, dass zeitintensive physische Tests wiederholt werden müssen – schlichtweg deshalb, weil vorangegangene Daten nicht mehr auffindbar oder interpretierbar sind.
Von isolierten Daten zu kontrollierter Zusammenarbeit
Die Lösung dieses Problems erfordert mehr als nur einen gemeinsamen Ordner oder ein neues Analyse-Tool. Eine moderne Plattform für das Testdatenmanagement schafft eine konsistente Datengrundlage für die technische Entwicklung – und ermöglicht es Ingenieuren gleichzeitig, ihre gewohnten Mess- und Analyseumgebungen weiterhin zu nutzen.
Peak Test Data Manager (PeakTDM) unterstützt diesen Ansatz durch:
- Integration von Testdaten aus heterogenen Quellen und Formaten
- Harmonisierung von Metadaten und Sicherstellung der langfristigen Interpretierbarkeit
- Ermöglichung der Auffindbarkeit über Abteilungen und Toolchains hinweg Implementierung rollenbasierter Zugriffskontrolle und Governance
- Unterstützung von Auditierbarkeit und Compliance-Anforderungen
- Anbindung von Testdaten an Python, Analyseplattformen und KI-Agenten
- Reduzierung von Schatten-IT und unkontrollierten Datenkopien
Anstatt etablierte Test- und Analysetools zu ersetzen, verknüpft PeakTDM diese mithilfe standardisierter Datenmodelle, Zugriffsmechanismen und Governance-Prozesse.
Die strategische Perspektive: Daten als wiederverwendbarer Vermögenswert
Testdaten sollten nicht bloß als Dokumentation bereits durchgeführter Experimente betrachtet werden. Mit ausreichenden Metadaten und klaren Governance-Strukturen werden sie zu einem wiederverwendbaren Wissenskapital, das fundiertere technische Entscheidungen über den gesamten Produktlebenszyklus hinweg ermöglicht.
Unternehmen, die ihr Testdatenmanagement modernisieren, können unnötige Tests reduzieren, die Zusammenarbeit zwischen verschiedenen technischen Fachbereichen fördern, die Revisionssicherheit verbessern, die Datensicherheit stärken und eine verlässlichere Grundlage für KI-gestützte Entwicklungsprozesse schaffen.
Wer dies versäumt, läuft Gefahr, Ineffizienzen, Compliance-Risiken und technische Schulden anzuhäufen – selbst dann, wenn gleichzeitig in modernere Testsysteme und Analyseplattformen investiert wird.
Die Frage, die es wert ist, gestellt zu werden
Verzehren Ihre Testdatensilos im Stillen Entwicklungskapazitäten – durch redundante Arbeit, verborgene Risiken und verpasste Innovationschancen? Oder verfügen Sie bereits über ein strukturiertes, zukunftsfähiges Datenfundament?
Wenn Sie den Reifegrad Ihrer aktuellen Testdatenmanagement-Strategie bewerten möchten, ermitteln Sie zunächst, an welchen Stellen es schwierig wird, Daten zu finden, zu interpretieren, miteinander zu verknüpfen oder zu verwalten.
Peak Solution unterstützt Unternehmen dabei, das Chaos bei Testdaten in kontrollierte, sichere und KI-fähige Erkenntnisse zu verwandeln.
Setzen Sie Erkenntnisse in die Tat um.Sprechen Sie mit Peak Solution über die Verbesserung von Datenzugänglichkeit, Nachvollziehbarkeit, Wiederverwendung und der Eignung für Analysen und KI – ohne Ihre bestehenden Tools zu beeinträchtigen.
Verbundene Lösungen
Die richtigen Komponenten. Die richtige Lösung. Für Ihre technischen Herausforderungen.
Peak Test Data Manager
Hören Sie auf, nach Testdaten zu suchen. Fangen Sie an, diese in einen echten Mehrwert für Ihre technische Arbeit zu verwandeln. Wandeln Sie verstreute Messdaten in eine verlässliche, jederzeit zugängliche und KI-fähige Datenbasis um.
